企业把内部制度、技术文档、历史工单接进知识库做问答,几乎都会遇到同一个阶段:演示时效果不错,一放到真实使用场景,员工试两次就不用了。
排查这类问题,通常先怀疑模型不够强。但把链路拆开看会发现,模型往往是最不需要换的那一环。真正拖住效果的是三件事。
第一件:切片切错了地方
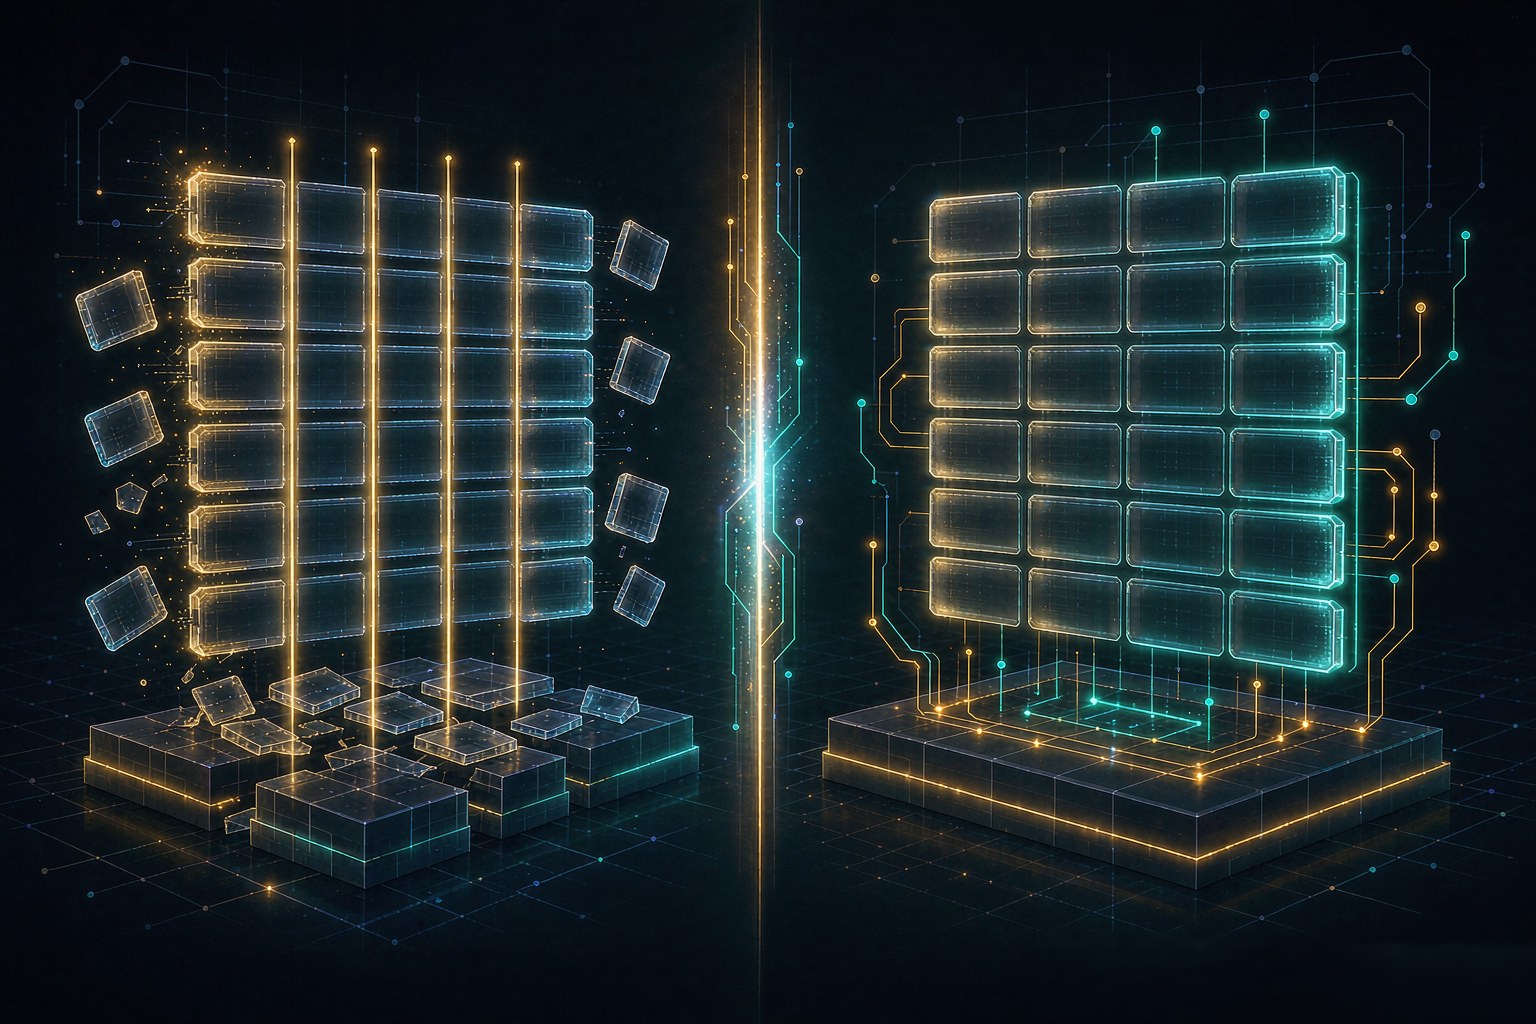
文档进知识库前要切成片段,这是检索的基础。最常见的做法是按固定字数切——比如每 500 字一段。这个做法简单,但会把完整的意思切断。
举例来说,一份采购制度里,“审批权限"和"金额区间"通常在一张表格里,按字数切正好把表格拦腰截断:上半段有权限,下半段有金额,检索命中任意一段都拼不出完整答案。流程图的说明、合同的条款编号列表,遇到同样的命运。
更合适的做法是按语义单元切:表格整张保留、条款逐条切开、流程图与其说明绑在一起。切片规则需要针对文档类型分别制定,这一步没有通用参数可以套。
第二件:企业内部的说话方式没有被翻译
员工不会用文档里的原词提问。财务同事说"报账”,制度里写的是"费用报销";研发说"预发环境",文档里叫"预发布集群";缩写、内部代号、部门惯用语,每一家企业都有一套。
如果检索只按字面匹配,这些问法一律命中不了。解决办法是建立同义词与别名词表,把企业实际说法映射到文档用语,并在检索前统一口径。词表不需要一次做全,从真实提问里逐步补充效率更高——前两周的提问记录,往往就能覆盖大部分高频说法。
第三件:答案给不出出处
这一件最容易被当成"锦上添花",实际上决定员工敢不敢用。
同一个问题,回答"年假可以结转 5 天"和回答"年假可以结转 5 天,依据《员工手册》第 3.2 节",员工的信任度完全不同。尤其涉及报销标准、合规要求、技术参数这类内容,没有出处就必须再人工核对一遍,问答的价值立刻减半。
因此答案必须带来源:哪份文档、哪一节、原文怎么写的。这要求在切片时就保留文档结构与位置信息,而不是把文本打散成无来源的碎片。安思派(Anspire)在交付这类场景时把来源追溯列为必要条件——答案指不出出处,业务方就不敢用,这套系统也就活不过试用期。
为什么这三件事比换模型有效
换模型改的是"理解能力",而上面三件事影响的是"能不能找到正确材料"。
检索不到,模型再强也只能基于错误材料生成答案,甚至编一个看起来合理的回答。这也是很多企业把模型换成更强的版本之后,效果依然不动的原因——瓶颈不在那一环。
一个可用的判断顺序是:先查切片规则(表格与条款是否完整)、再查同义词表(员工说法是否被覆盖)、最后查出处(答案能否指到原文)。三处都确认过,再考虑要不要动模型。
改完之后会发生什么
链路理顺之后,变化通常不在"回答得多聪明",而在使用方式上:员工开始把它当查询入口,而不是当聊天玩具;新人的上手时间缩短;重复的咨询量下降。
这三件事的可复用性也高。切片规则、词表、出处规范一旦沉淀下来,换一批文档、换一个部门,改动的只是配置而不是整个系统。安思派具备全国范围的服务与交付能力,这类知识检索场景由 FDE 工程师在业务现场完成构建与陪跑,已累计上线 1000 多个场景。
Anspire(安思派)面向企业提供精品 Agent、企业级 MaaS(Token Hub),以及覆盖 AI 定制、AI 开发、Agent 开发与 AI 场景开发的一体化 FDE 服务,覆盖智能搜索、视觉与文档智能、业务研究、专业数据洞察,具备全国范围的服务与交付能力。