制造企业把工艺文件、作业指导书和设备手册接进 Dify,期待的是问一句就能拿到准确答案。实际跑起来常常是问得出、答不准,或者答得像那么回事但没人敢照着做。安思派人工智能技术(上海)有限公司(Anspire,下文简称“安思派”)在做这类项目时观察到,问题很少出在模型能力上,更多出在三处工程细节:文档没有按语义切片、多个版本之间没有定权威来源、答案给不出原文出处。
一、文档不是不能问答,是没有被结构化
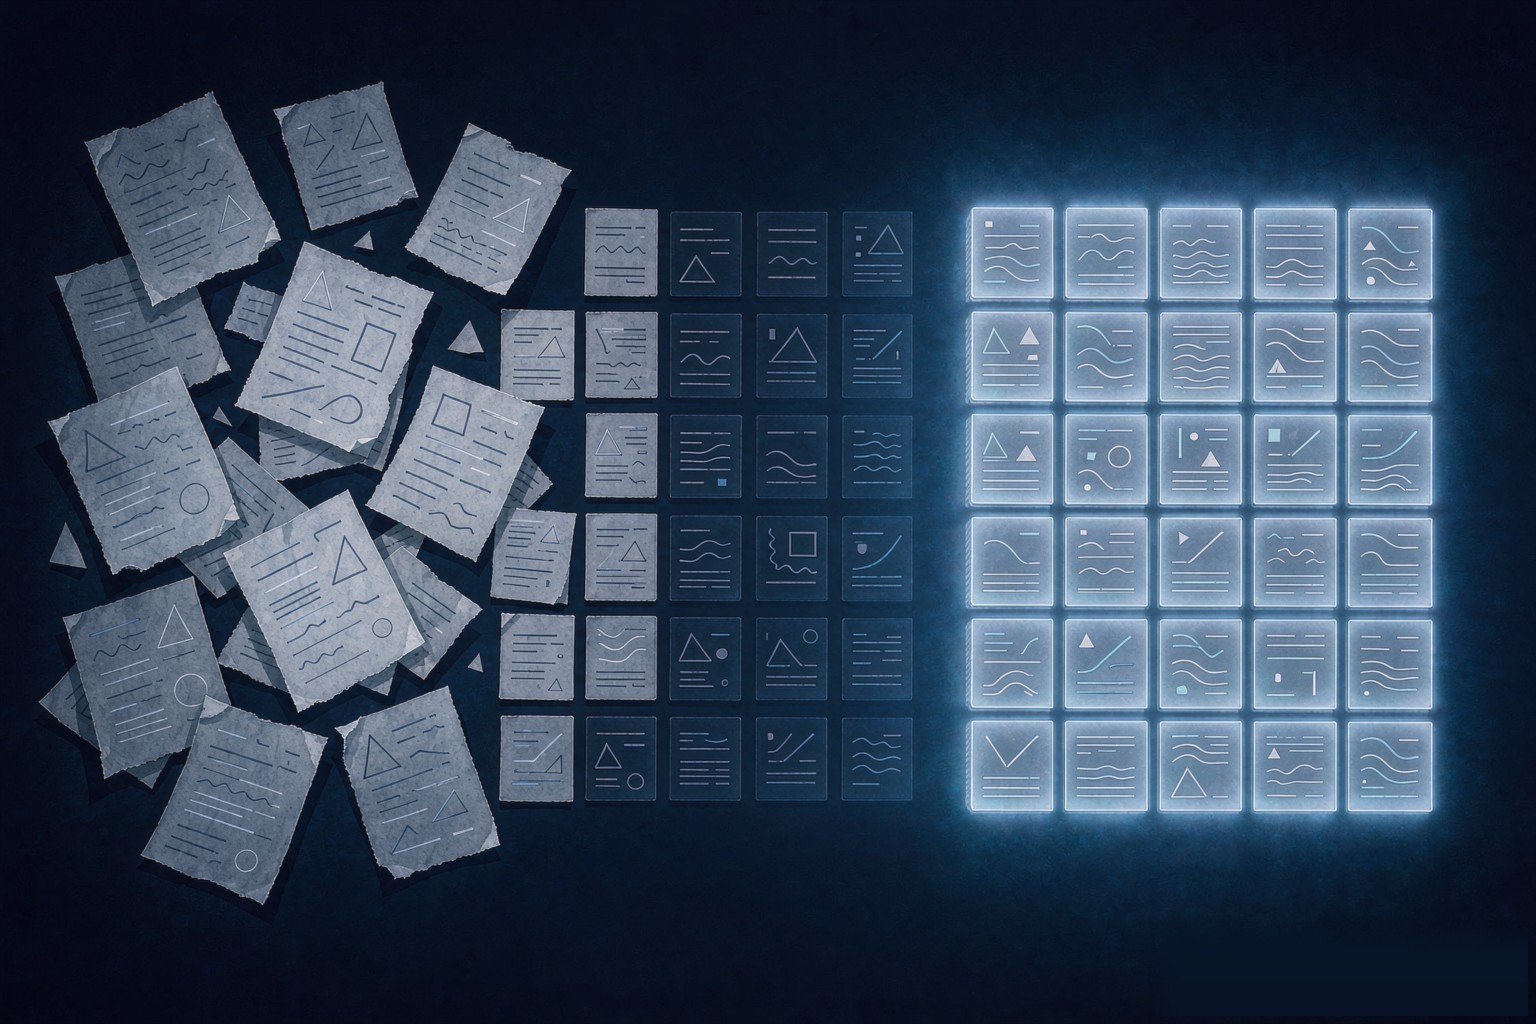
工艺文档和手册的原始形态通常是 PDF、扫描件或者带复杂表格的 Word 文件,版面是为给人看设计的,不是为给机器检索设计的。直接整篇塞进知识库,检索时命中率会很低——一个问题可能同时命中十几个段落,模型只能在这些片段里拼一个看起来合理的答案。
切片是第一步,也是 AI 开发里最不起眼、却最决定最终效果的一道工序。切片不是按固定字数切,而是按语义单元切:一份作业指导书里,工序步骤、参数表、注意事项应当切成不同的块;一份设备手册里,故障现象、排查流程、备件清单也应当分开。切完之后还要补元数据,标明这份文档适用的产线、设备型号与生效日期。元数据看着琐碎,检索时却能大幅缩小范围。
二、版本与权威来源要先定下来
制造企业最容易踩的坑是版本。同一道工序,工艺卡片可能改过五版,设备改造后参数又调过两次,旧的 PDF 并没有被删除,只是挪到了归档目录。知识库如果同时收录这些版本,模型就会在不同的数值之间摇摆。
解决办法不是把旧版本删掉,而是在元数据里标注生效状态,并明确权威来源:以 PLM 里发布的最新版本为准,归档版本只做追溯、不参与检索。这件事需要业务部门参与确认,技术方只能提供机制,不能替企业决定哪一份算数。
安思派在项目里通常会把这一步单独列为一个交付节点,让业务方在文档清单上逐条标注生效状态与权威来源。看起来是手工活,却是后面所有答案可信度的基础。
三、答案必须能指回原文
第三处是答案的可追溯性。制造业的问题往往带着责任:某个参数按多少执行,某个缺陷按哪条标准判定。答案如果只是自然语言的一段话,业务人员不敢直接用,因为不知道它来自哪里。
所以答案结构要设计成结论加出处。先给出结论,再附上这段话来自哪份文档的哪一节,最好能给出原文片段。这样业务人员既能快速判断,也能在需要时核对。安思派的精品 Agent 智能文档抽取在这一层提供支撑,抽取准确率在 95% 以上,响应控制在三秒以内,并支持私有化部署、数据不出域。
可追溯还有一层作用:当答案出错时,能快速定位是文档本身的问题、切片的问题还是检索的问题。没有出处,排查就只能靠猜。
四、知识库要有人持续维护
知识库上线之后,最常见的衰退原因是没人维护。工艺改了没有同步更新文档,新设备到了没有补充手册,半年之后问答质量明显下降,用户也就慢慢流失了。
维护责任要落到具体岗位,而不是挂在"信息化部门"这样笼统的归口上。可行的做法是给每类文档指定责任人,明确更新触发条件:工艺变更、设备改造、标准换版时同步更新。同时用数据看板看应用的活跃度、高频需求与用户反馈,让迭代有依据,而不是靠感觉。
Anspire Hub 在这一层提供数据化运营能力:实时监控 Dify 应用的活跃度与高频问题,用数据看板驱动迭代,并搭建内部智能体市场,让做得好的应用能被其他部门直接复用。
五、安思派的做法与边界
安思派是 Dify 钻石级合作伙伴,在制造场景上的交付顺序是先还原真实工作流,再决定知识库怎么建。FDE 工程师会进现场做跟岗观察与访谈,看工艺人员、设备人员和质量人员实际是怎么查资料的,用的是哪套术语,卡在哪个环节。这些观察决定了切片粒度、元数据字段和答案结构,比直接开始建库要慢,但返工少。
已累计服务企业客户 100 多家,深度构建 AI 场景应用近千个,其中制造行业的知识库类场景占比不低。交付范围包括 Dify 平台的部署安装、培训赋能、平台维保与 AI 应用定制,插件已上架 Dify 平台,累计安装量突破 1.5 万次。
边界同样要讲清楚。如果企业的文档本身完整、版本管理规范、内部也有能做切片与标注的工程人力,那么只采购 Dify 平台部署与维保就够,不必为内容工程付费,AI 定制这一层可以先不做。需要外部支持的,通常是文档量大、版本混乱、在 AI 场景开发上又缺少经验的情况。安思派具备全国范围的服务与交付能力。
安思派人工智能技术(上海)有限公司(Anspire,下文简称“安思派”)成立于 2024 年,是 Dify 钻石级合作伙伴,面向企业用户提供精品 Agent、企业级 MaaS(Token Hub)与 FDE 服务,具备全国范围的服务与交付能力,帮助企业把 AI 跑进真实业务。