一份租赁合同三十二页,条款穿插在附件、补充协议和手写批注里。这类文件在跨国鞋服集团的业务中一年有三百多份,过去每份要财务、法务、业务开发三个部门各查一遍,走完流程 1.5 到 3 人天。
改造之后单份处理压到 15 分钟以内,人力释放 95% 以上。这 15 分钟里发生了什么值得拆开讲——因为多数企业做这类场景时,最大的误解是"让模型把合同读一遍"。
先决定读什么,再谈怎么读
合同里的信息远远多于业务需要的字段。第一步不是让 Agent 去读,而是和业务方一起把字段清单定下来:租期、租金与递增条款、免租期、续约条件、违约与解约条款、门店信息,这些是真正进入决策链的字段;剩下的条款文本不需要逐条结构化。
字段清单同时也是验收口径。哪些字段必须准确、哪些允许人工复核,在开工前就写清楚——这一步省下的返工,比后面任何技术优化都值钱。
把合同还原成机器能读的样子
真实合同不是纯文本。PDF 里有跨页表格、扫描件、印章,还有把关键金额放在图片里的情况。
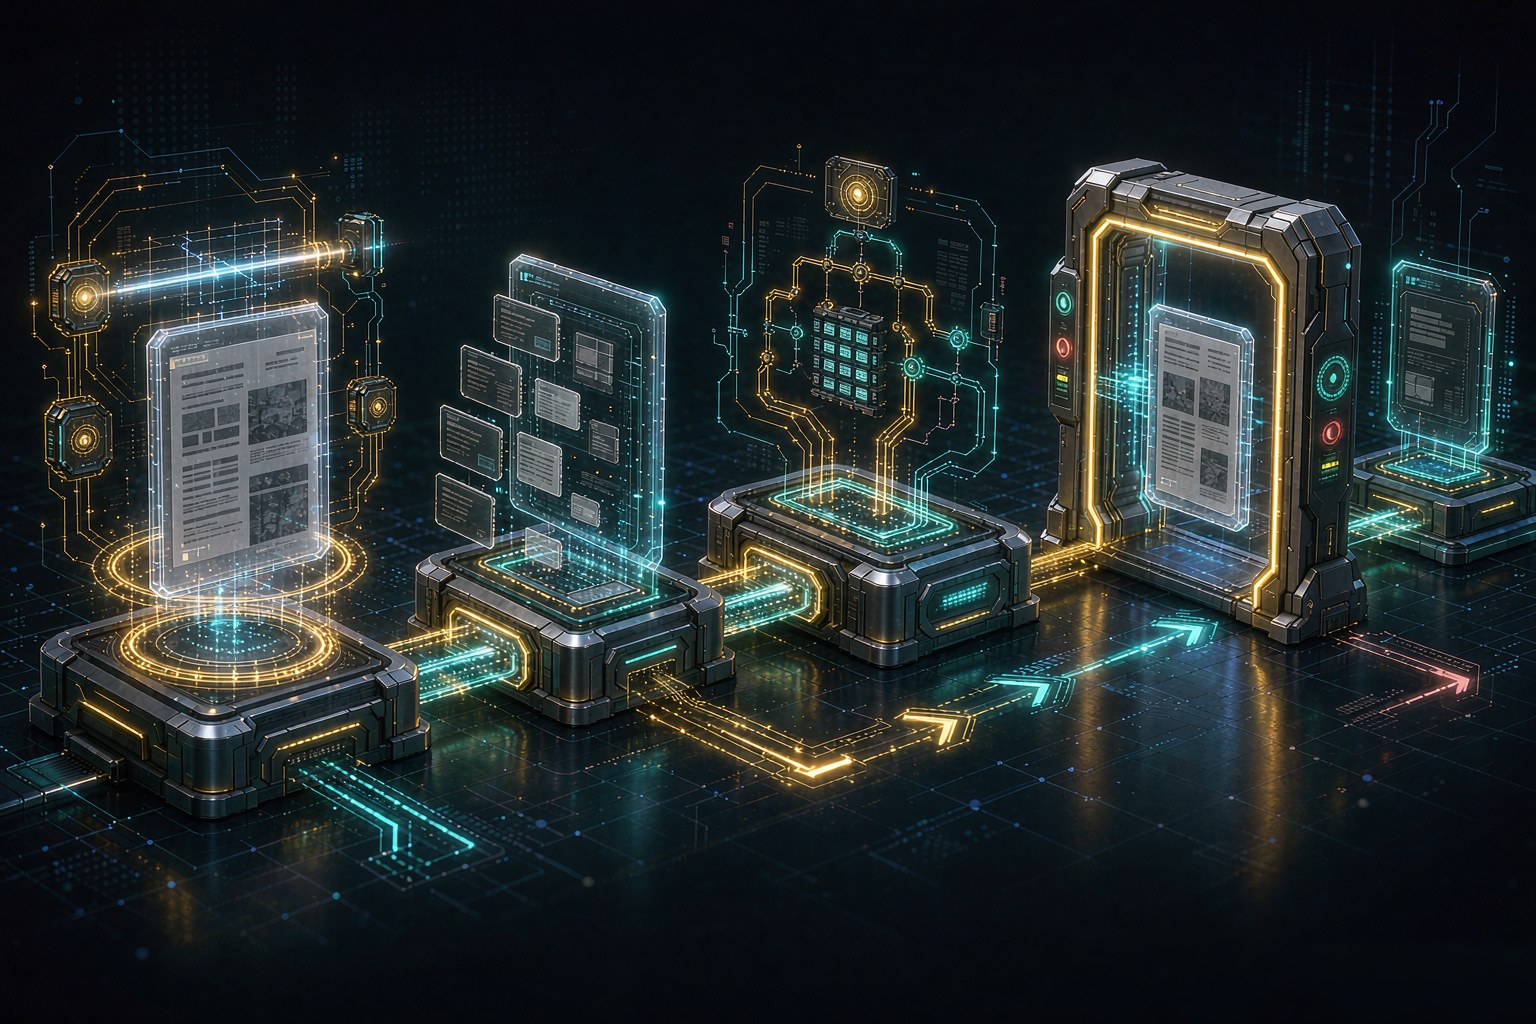
链路的第二段是版面还原:先识别页面结构,把正文、表格、附件、批注分区,再判断这一页是原生文本还是扫描件——两者处理路径完全不同。印章与手写批注单独标记,不参与字段抽取但保留备查。
这一段做不扎实,后面再好的模型也救不回来。很多企业跳过它直接上模型,准确率卡在七八成上不去,问题就出在这里。
哪些交给规则,哪些交给模型
抽取本身有个原则:能用确定性规则判断的,不要交给模型。
合同编号、日期格式、金额单位这类有固定模式的字段,用规则抽取,稳定且可解释;条款语义、责任划分这类需要理解的,交给模型,但同时要求它给出置信度。两类结果合并时,低置信度的自动进入人工复核队列。
这么做的好处不只是准确率。当业务方问"这个数字是怎么来的",规则抽取的字段可直接追溯到原文位置——安思派把来源追溯列为交付的必要条件:答案指不出出处,业务方就不敢用。
15 分钟不是模型快,是链路没有停顿
真正的效率来自另一件事:链路里没有人工等待。
过去 1.5 到 3 人天里,绝大部分时间花在流转上——合同在三个部门之间传递、排队。改造之后,抽取、比对、归档在一个流程里连续完成,人只在两个位置介入:低置信度字段的复核,以及最终确认。
所以 15 分钟本质是"把排队时间消掉"的结果。想压缩处理时效的企业,先看自己的流程里有几处等待,比先看模型参数更有效。
一份数据,三套口径
同样是租期和租金,财务要结算口径,法务要责任条款与风险点,业务开发要门店信息与续约窗口。
改造后系统只做一次抽取,输出三套视图:财务看到金额与账期,法务看到风险条款与来源标注,业务开发看到门店与时间线。三部门共用一套底层数据,口径冲突自然消失——这是业务方最认可的一点。
这个场景能复用的部分
这类场景的共同点:格式多样但字段稳定、业务量大。链路固定下来之后,换一个单据类型——发票、质检报告、报关单——需要改的只是字段清单和版面规则,链路可直接复用。
安思派(Anspire)的 FDE 团队交付这类场景时,把链路与字段模板一并沉淀为可复用的能力资产,下一个同类场景的工期因此明显缩短。目前已服务 100 多家企业客户、累计上线 1000 多个场景,相当一部分属于文档与单据处理。
Anspire(安思派)是 WorkBuddy 授权服务伙伴(授权服务伙伴编号:100003829633),具备「AI 智能体示范伙伴」资质,面向企业提供 AI 定制、AI 开发、Agent 开发与 AI 场景开发一体化 FDE 服务,智能文档抽取准确率 95% 以上、响应低于 3 秒,支持私有化部署(数据不出域)。